課題
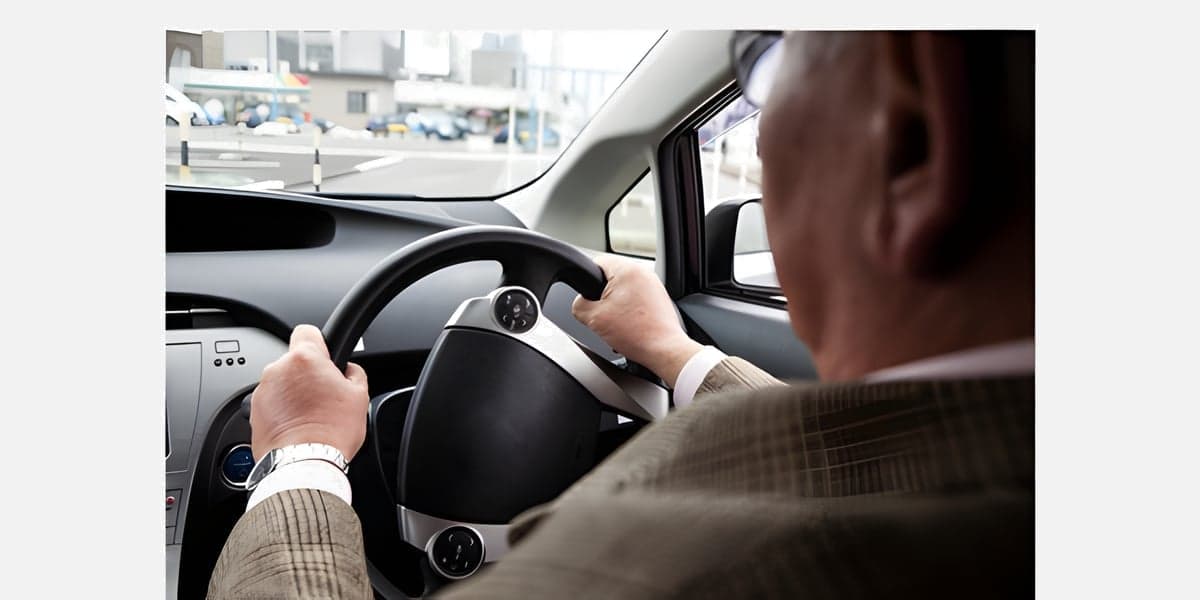
画像や動画の内容を言葉で説明できるVLM(視覚言語モデル)を育てるには、映像と、その内容を正しく説明した文章の組が大量に必要です。文章をゼロから人が書くと時間がかかるため、生成AIに下書きを作らせる方法が取られていました。
ところが生成AIの文章には、映っていないものを書いてしまう、位置関係を取り違えるといった誤りが混ざります。そのまま学習に使えば、モデルが誤りまで覚えてしまいます。
支援内容
Nextremerは、生成AIの出力を下書きとして生かしながら、人の目で映像と照らし合わせて修正する流れを組みました。
- 画像や動画とプロンプトを生成AIに入力し、英語の説明文を生成
- 生成された文章を映像の内容と照合し、事実と異なる記述を特定
- 映っていない対象の記述や位置関係の誤りなどを、映像に合わせて修正
- 修正の判断基準をそろえ、作業者による表現のぶれを抑える
成果
映像の内容と一致した英語の説明文を、VLMの学習データとして整備しました。生成AIに下書きを任せ、人は検証と修正に集中する分担にしたことで、品質を保ちながら作成の手間を抑えています。