フィジカルAI・ロボティクス向け データセット
人がどう動き、物をどう扱うのか。ロボットの学習に欠かせない一人称視点のマルチモーダルデータを、パートナー企業と連携してご提供します。
取り扱いデータセット
1件のデータセット
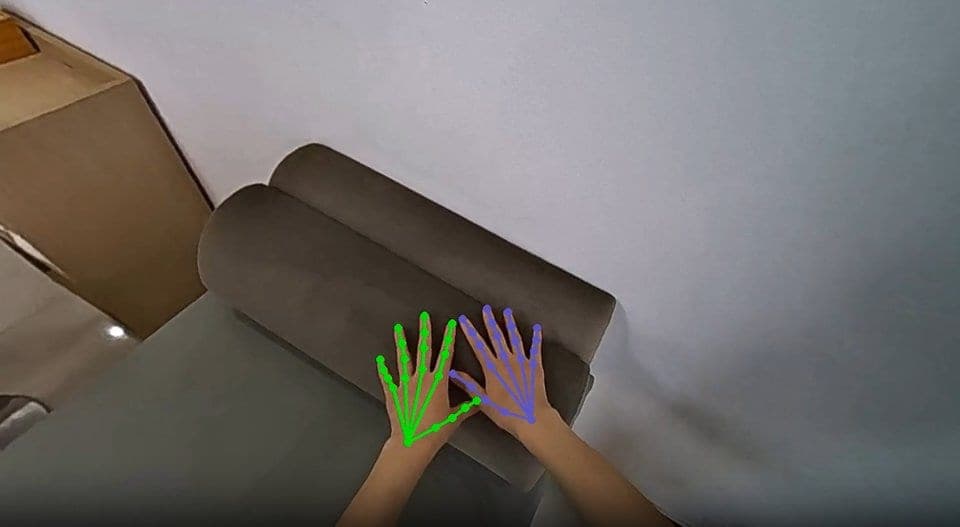
Xperience Enterprise
100,000時間
9種類の実環境シーンで収録した、大規模な一人称視点マルチモーダルデータセット。ロボット基盤モデルの事前学習に。
- シーン数
- 5,000
- シーンタイプ
- 9種類
Coming soon
新しいデータセットを準備中です
取り扱いを開始しましたら、このページでご紹介します。
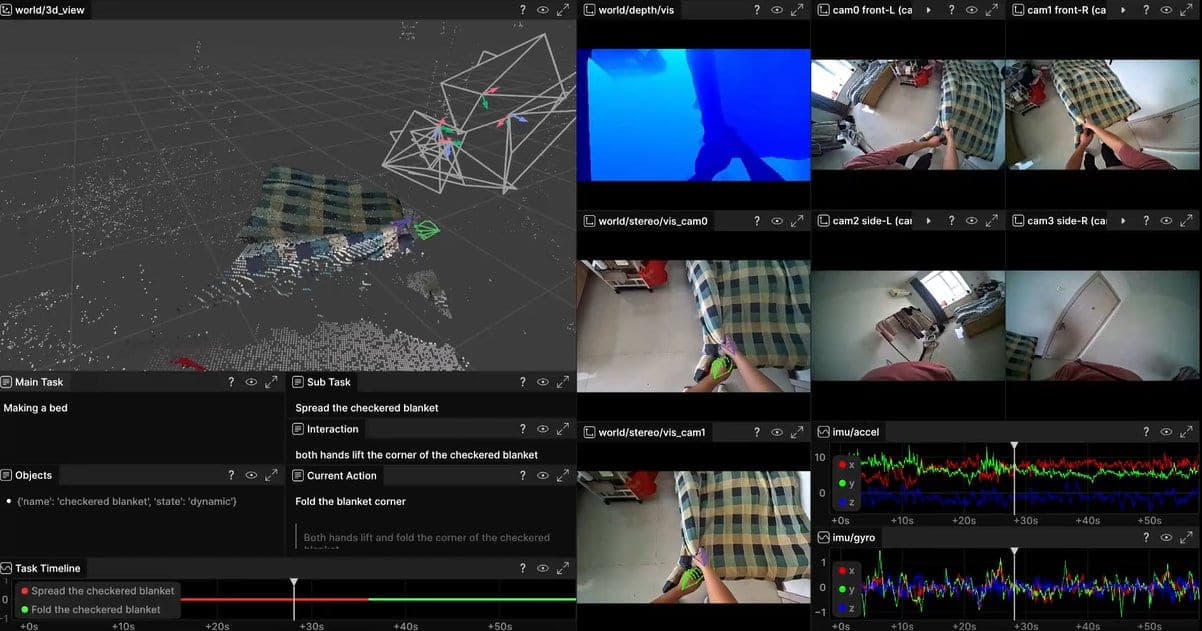
RGB映像 
深度 
手の骨格
Xperience Enterprise
頭部装着型デバイス「HOMIE Gen2」で人の日常動作を一人称視点で収録した商用データセットです。広角映像・IMU・深度・姿勢・セマンティックラベルを同期させ、9種類の実環境シーンにわたってアノテーションを付与しています。
| 収録時間 | 100,000時間 |
|---|---|
| シーン数 | 5,000シーン |
| シーンタイプ | 9種類 |
| モダリティ層 | 8層 |
| 収録デバイス | HOMIE Gen2(頭部装着型マルチモーダル収録デバイス) |
| サンプル | rrd形式(専用ビューアで閲覧) |
収録データの種類
複数のセンサーデータを共通の時間軸で同期しています。
- RGB映像
- 深度
- 音声
- IMU(慣性計測)
- ハンドトラッキング
- 移動軌跡
- モーションキャプチャ
- 言語アノテーション
計測精度
納品バッチごとに精度を検証しています。
- 自己位置推定(SLAM)
- 1.02 cm
- 6 m の移動での位置誤差
- 深度
- 2.5% 未満
- 4回の撮影・距離 0.38–1.27 m・n=1,876(観測数)での距離誤差
- 手の姿勢推定
- 4.68 mm
- 手の21関節・有効シーケンス12本での関節位置誤差(フレーム単位)
- 動作キャプション
- 96.0%
- 現在の行動の正解率(n=321)
出典:Ropedia公表値(検証日:2026年8月5日)
想定される用途
- ロボット基盤モデルの事前学習
- VLA(視覚・言語・行動)モデルの学習
- ワールドモデルの構築
- ロボットハンドによる器用な操作の学習
- 複数ステップにわたるタスク計画
- 人の実演からの模倣学習
まずは500時間の評価用セットから
100,000時間のフルデータセットに加え、500時間の評価用セットもご用意しています。お客様のモデルや用途への適合性をご確認いただいたうえで、本格導入をご検討いただけます。お気軽にお問い合わせください。
データの選定から加工まで、 Nextremerがお手伝いします
アノテーション事業で培ったノウハウを生かし、購入したデータをすぐに学習に使える形に整えます。
日本語でのご相談・ご契約
海外パートナーのデータも、Nextremerが窓口となって日本語でご案内します。
用途に合ったデータの選定
研究テーマやモデルの要件をうかがい、適したデータセットをご提案します。
追加のアノテーション・データ加工
独自のラベル付けやフォーマット変換など、学習に必要な加工を承ります。